1. tcp超时重传
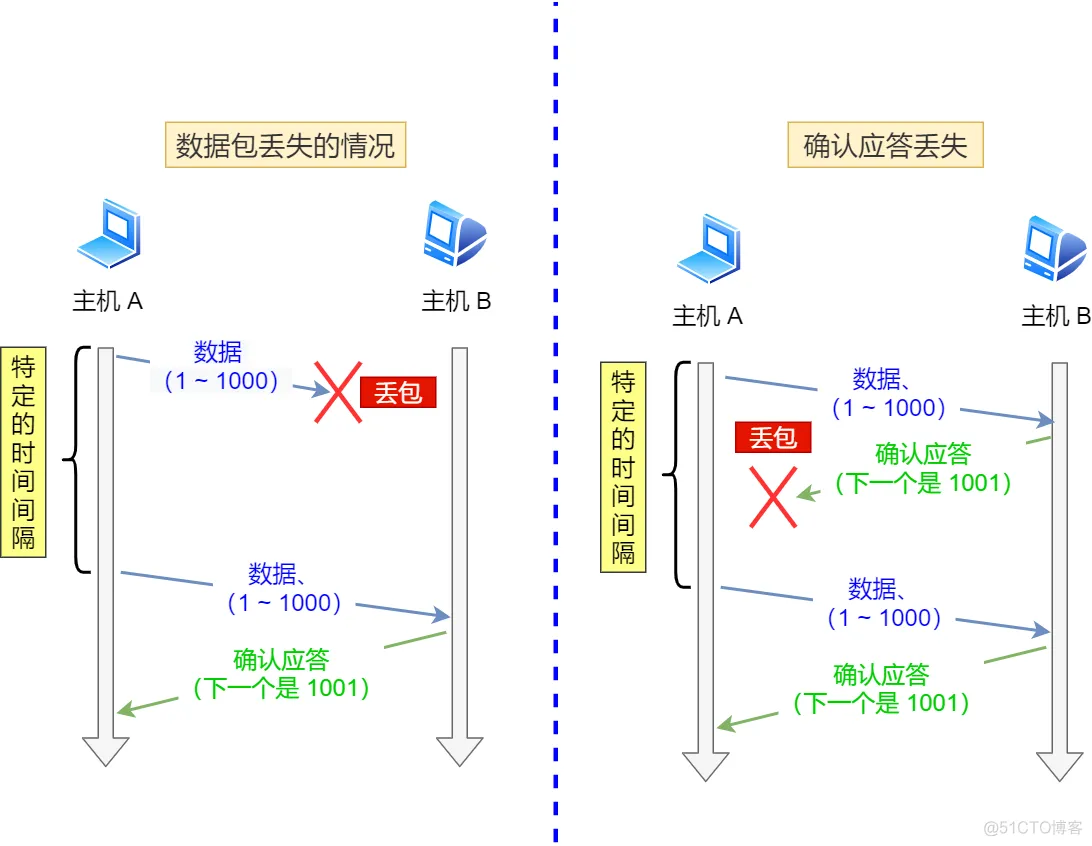
重传机制的其中一个方式,就是在发送数据时,设定一个定时器,当超过指定的时间后,没有收到对方的ACK确认应答报文,就会重发该数据,也就是我们常说的超时重传。
TCP 会在以下两种情况发生超时重传:
- 数据包丢失
- 确认应答丢失
1.1. RTT与RTO
- RTT(Roud Trip Time): 往返时延,从数据包发出去到接收到ACK的时间。RTT是连接粒度的,每个连接都有一个独立的RTT
- RTO(Retransmission Time Out):重传时间
!性能指标#7. 往返时间(Round-Trip Time,RTT)
超时重传时间是以 RTO (Retransmission Timeout 超时重传时间)表示。
假设在重传的情况下,超时时间 RTO 「较长或较短」时,会发生什么事情呢?
- 当超时时间 RTO 较大时,重发就慢,丢了老半天才重发,没有效率,性能差;
- 当超时时间 RTO 较小时,会导致可能并没有丢就重发,于是重发的就快,会增加网络拥塞,导致更多的超时,更多的超时导致更多的重发。
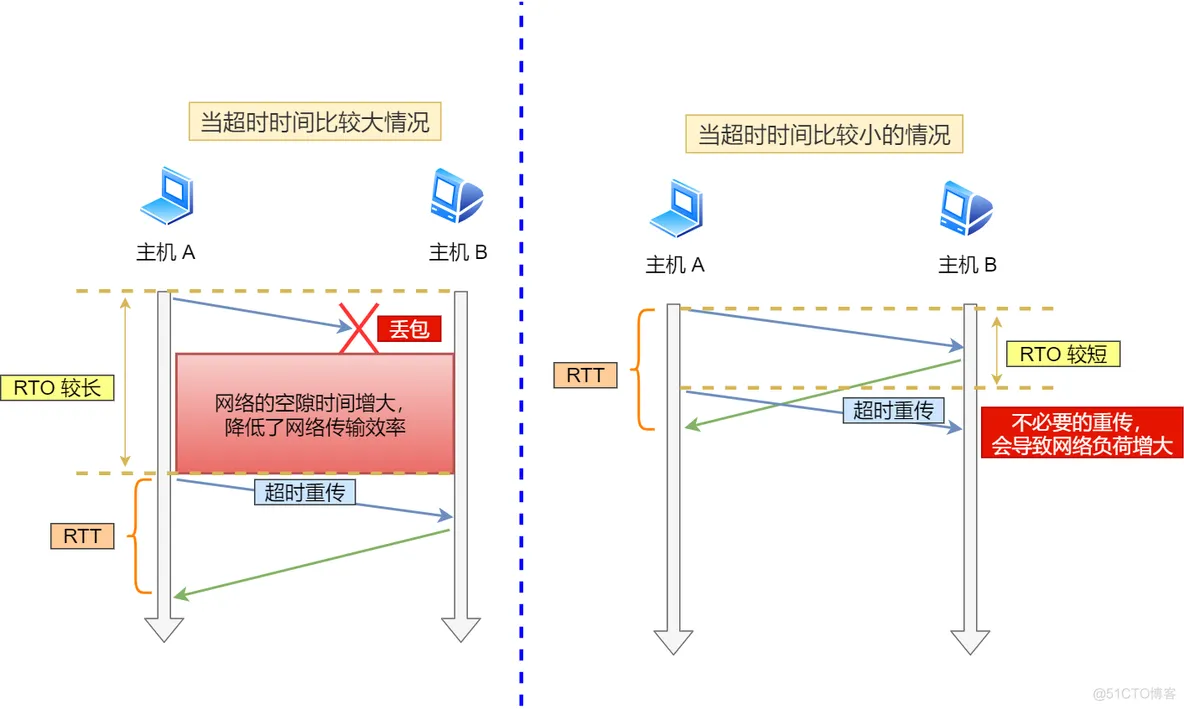
精确的测量超时时间 RTO 的值是非常重要的,这可让我们的重传机制更高效,超时重传时间 RTO 的值应该略大于报文往返 RTT 的值。
1.2. RTT经典计算方案
最初的规范RFC0793采用了加权滑动平均来估算RTT,即SRTT(Smoothed Round Trip Time)
SRTT = ( ALPHA * SRTT ) + ((1-ALPHA) * RTT)
RTO计算如下,其中UBOUND是timeout的上限(1min),LBOUND是timeout的下限(1s),ALPHA是加权因子(0.8-0.9),BETA是时延方差系数(1.3-2)
RTO = min[UBOUND,max[LBOUND,(BETA*SRTT)]]
1.2.1. 存在的问题
1.2.1.1. 二义性
RFC1122 指出当出现数据包重传的情况下,RTT的计算会出现二义性。在测量RTT样本的过程中若一个包的传输出现超时,该数据就会被重传,接着收到一条ACK信息,那么该ACK是对第一条还是第二条传输的确认就存在这二义性。对于客户端来说,它不知道发生了哪种情况,选错情况的结果就是RTT偏大/偏小,影响到RTO的计算。(最简单粗暴的解决方法就是忽略有重传的数据包,只计算那些没重传过的,但这样会导致在网络环境突然恶化的场景下,大量重传数据包没有被用来计算RTT,导致RTO无法更新,进而导致每一个分片报文都一直被重传,详见 Karn's algorithm)。
开启 Timestamps 时例外:如果双方开启了 TCP Timestamps 选项,ACK 中会带回原始发送的时间戳,此时 TCP 可以精确区分,就可以直接用重传包的实际 RTT 来即时更新 RTO。
1.2.1.2. 网络性能恶化加剧
RTT的加权平均算法,ALPHA系数一般都比较大,本质上是一个低通滤波器,对突然的网络波动不敏感,如果网络时延突然增加会导致实际RTT值大于预估值,导致不必要的重传,加重网络负担。
1.3. RTT最新方案
RFC6298 提出基于滑动平均值SRTT和平均偏差RTTV(Round-Trip-Time variation)来综合计算。
1.3.1. 基础计算公式(正常传输状态)
在网络无丢包、正常传输时,TCP 会通过测量每个报文的往返时间(RTT),动态计算重传超时时间(RTO)。根据 RFC 6298 标准,计算包含以下两个核心变量:
- 平滑往返时间(SRTT):消除网络抖动后的 RTT 平均值。
- RTT 波动偏差(RTTVAR):RTT 的偏离程度/方差。
1.3.1.1. 计算公式:
(注:RFC 默认权重系数参数 \alpha = 0.125,\beta = 0.25;且 RTO 通常有最小值和最大限制,如 200ms-120s)
1.3.2. 超时重传时的计算规则:指数退避(Exponential Backoff)
当出现数据包丢失且没有及时收到 ACK 时,TCP 触发超时重传,进入重传阶段。
- 连接级退避(非单报文隔离): 重传定时器(Timer)是针对整个 TCP 连接的。一旦发生超时,连接的全局 RTO 会按照 2^n 进行翻倍:\text{RTO}_{\text{retrans}} = \text{RTO}_{\text{base}} \times 2^n \quad (n = 1, 2, 3 \dots)
- 多次丢包的连续退避: 如果连接中存在多个报文丢失(如报文 1、报文 2 均丢失),报文 1 重传成功后,若报文 2 依然超时,重传计数器 n 继续累加(RTO 继续向更高的倍数翻倍,如 800\text{ms} \to 1600\text{ms}),而不会重置。
- 退避上限: RTO 的翻倍不会无限制增加,通常会在达到系统上限(Linux 下默认最大为 120 秒)或达到最大重传次数(
tcp_retries2,默认 15 次)后中断连接。
1.3.3. 重传期间 RTT 采样的两种更新模式
在重传恢复期内,后续报文发出的 ACK 能否用于更新 RTO,取决于系统是否开启了 TCP Timestamps(时间戳选项):
| 机制 / 模式 | 开启 TCP Timestamps (现代系统默认) | 未开启 TCP Timestamps (经典 Karn 算法) |
|---|---|---|
| 重传包与 ACK 辨识 | 通过 ACK 报文中的 TSecr 头部精准识别原始发送时刻,消除二义性。 |
无法区分 ACK 是回应第一次发送还是第二次重传。 |
| 重传期间 RTT 采样 | 正常采样更新:无论是重传包还是后续新报文(如 5,6,7),均可准确计算 RTT 并即时重置/调整 RTO。 | 完全冻结采样:触发 Karn 算法,重传期间所有报文的 RTT 采样均被丢弃,防止干扰。 |
| 退避状态解除 | 收到任意带时间戳的有效 ACK 时,即可修正 RTO,提前退出退避。 | 必须等待所有重传数据彻底被确认且收到全新报文的 ACK 时才重置 RTO。 |
1.3.4. 完整演变场景示例
1.3.4.1. 示例背景设定:
- 初始基准 \text{RTO} = 200\text{ms}。
- 连续发送了报文 1、2、3、4、5。
- 发生异常:报文 1 与 报文 2 在链路上丢失,报文 3、4 被接收方收到并触发了 SACK;后续又合规发送了报文 5。
- 环境为未开启 Timestamps(经典 Karn 算法)。
1.3.4.2. 动态演变时序图与说明:
时间 (ms)       发送方 (Sender)                           接收方 (Receiver)
  |
0ms   --------> 发送 报文 1, 2, 3, 4 -----------------------> [报文 1, 2 丢失!]
  |                                                          [收到 3, 4,回复 SACK 3-4]
200ms --------> 【报文 1 超时!】
  |             • 触发第 1 次重传 (n=1)
  |             • RTO 翻倍: 200ms × 2¹ = 400ms
  |             • 重传 报文 1
  |             • 发送全新 报文 5 --------------------------> [收到 5,回复 SACK 3-5]
  |
250ms <-------- 收到 SACK 3-5 -------------------------------
  |             • 确认 3, 4, 5 已到达 (SACK生效)
  |             • Karn算法生效:RTO 维持 400ms 退避,不更新 RTT
  |
600ms --------> 【报文 1 重传成功,但 报文 2 依然超时!】
  |             • 触发第 2 次重传 (n=2)
  |             • RTO 再次翻倍: 200ms × 2² = 800ms (基于前次递进)
  |             • 重传 报文 2 ------------------------------> [收到 2,发送 累积 ACK 6]
  |
700ms <-------- 收到 累积 ACK 6 ------------------------------
  |             • 报文 1~5 彻底全部被确认!连接退出重传恢复期
  |             • 发送全新 报文 6
  |
750ms <-------- 收到 报文 6 的 ACK ---------------------------
  |             • 获得无歧义的全新 RTT 采样 (50ms)
  |             • 重置重传计数器 (n=0),RTO 恢复为正常计算值 (如 200ms)
根据公式计算后结果可能小于200ms,但是tcp限制了RTO最小为200ms
如果报文 6 的实际传输耗时达到了 300ms,则重新计算的RTO应该为\text{RTO} = \text{SRTT} + 4 \times \text{RTTVAR} = 81.25 + 4 \times 70 = \mathbf{361.25\text{ms}}。
1.3.5. 核心结论总结
- 正常时:RTO 由公式 \text{SRTT} + 4 \times \text{RTTVAR} 实时计算,反映实际网络延迟
- 超时时:RTO 触发指数退避(2^n \times \text{RTO}),该退避作用于整个连接,用于保护拥塞网络
- 多包重传时:退避倍数连续递进,只有当所有丢失的重传包全被确认后,退避状态才会被重置。
- SACK 与 Timestamps:SACK 解决“哪些数据到了”的精确定位;Timestamps 解决“时间精准测量”,使 TCP 在重传期间也能安全更新 RTO。
linux下tcp_retries2用于控制tcp重传的次数,若发生网络中断,预估需要15min以上才会放弃连接。
root@vultr:~# cat /proc/sys/net/ipv4/tcp_retries2
15
root@vultr:~# sysctl net.ipv4.tcp_retries2
net.ipv4.tcp_retries2 = 15
指数重传的时间只对发生重传的报文生效,正常发送成功并ack的报文会正常加入RTT的计算
2. 快速重传
TCP 还有另外一种快速重传(Fast Retransmit)机制,它不以时间为驱动,而是以数据驱动重传。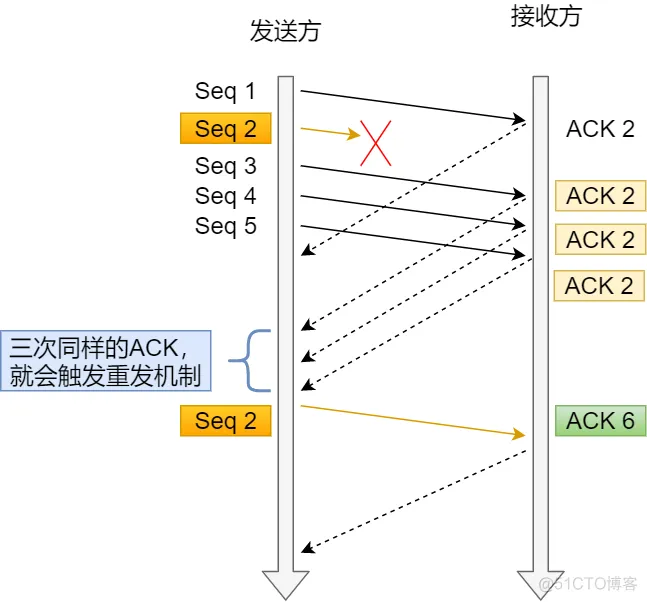
在上图,发送方发出了 1,2,3,4,5 份数据:
- 第一份 Seq1 先送到了,于是就 Ack 回 2;
- 结果 Seq2 因为某些原因没收到,Seq3 到达了,于是还是 Ack 回 2;
- 后面的 Seq4 和 Seq5 都到了,但还是 Ack 回 2,因为 Seq2 还是没有收到;
- 发送端收到了三个 Ack = 2 的确认,知道了 Seq2 还没有收到,就会在定时器过期之前,重传丢失的 Seq2。
- 最后,收到了 Seq2,此时因为 Seq3,Seq4,Seq5 都收到了,于是 Ack 回 6 。Note
快速重传的工作方式是当收到三个相同的 ACK 报文时,会在定时器过期之前,重传丢失的报文段。
3. SACK
快速重传机制只解决了一个问题,就是超时时间的问题,但是它依然面临着另外一个问题。就是重传的时候,是重传之前的一个,还是重传所有的问题。
比如对于上面的例子,是重传 Seq2 呢?还是重传 Seq2、Seq3、Seq4、Seq5 呢?因为发送端并不清楚这连续的三个Ack 2是谁传回来的,以上两种情况都是有可能的。可见,这是一把双刃剑。为了解决不知道该重传哪些 TCP 报文,于是就有 SACK 方法。
这种方式需要在 TCP 头部「选项」字段里加一个 SACK 的东西,它可以将已经接收到缓存队列的seq信息发送给发送方,这样发送方就可以知道哪些数据收到了,哪些数据没收到,知道了这些信息,就可以只重传丢失的数据。
如下图,发送方收到了三次同样的 ACK 确认报文,于是就会触发快速重发机制,通过 SACK 信息发现只有 200~299 这段数据丢失,则重发时,就只选择了这个 TCP 段进行重复。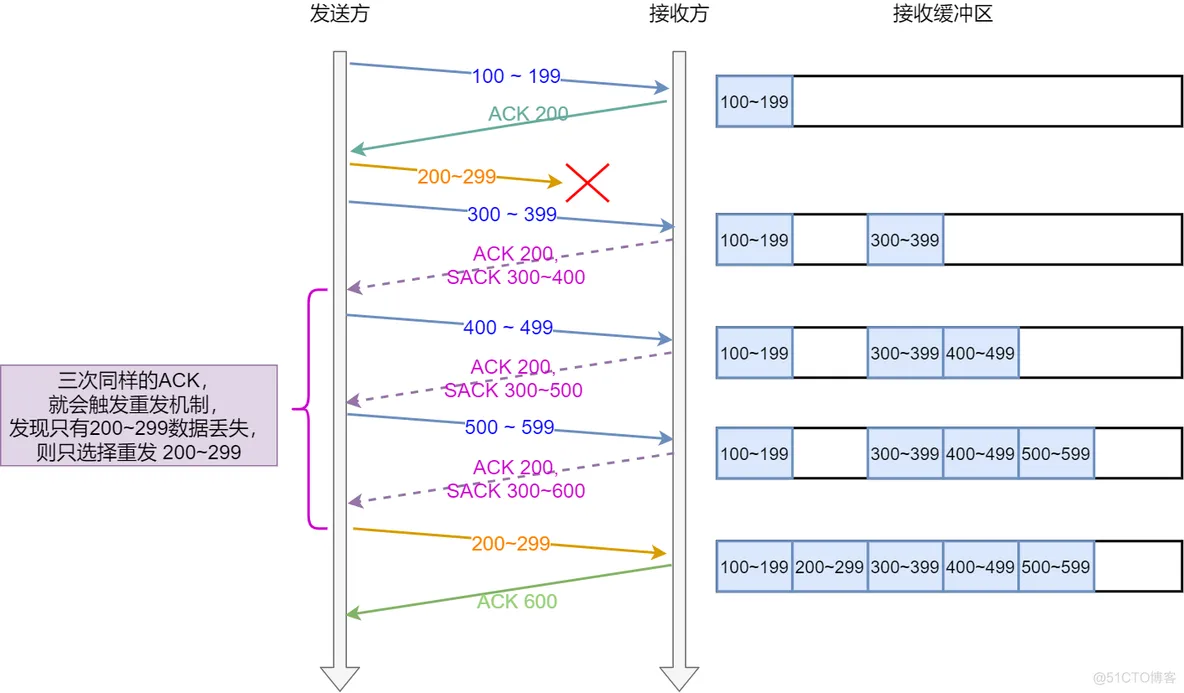
如果要支持 SACK,必须双方都要支持。在 Linux 下,可以通过 net.ipv4.tcp_sack 参数打开这个功能(Linux 2.4 后默认打开)。
root@vultr:~# sysctl net.ipv4.tcp_sack
net.ipv4.tcp_sack = 1
4. Duplicate SACK
Duplicate SACK 又称 D-SACK,其主要使用了SACK来告诉「发送方」有哪些数据被重复接收了。
sack表现是ack小与sack,代表丢数据了,但是我可以提前ack后面的;D-sack表现是ack大于sack,说明数据重复了,你发给我的数据我已经ack过了。
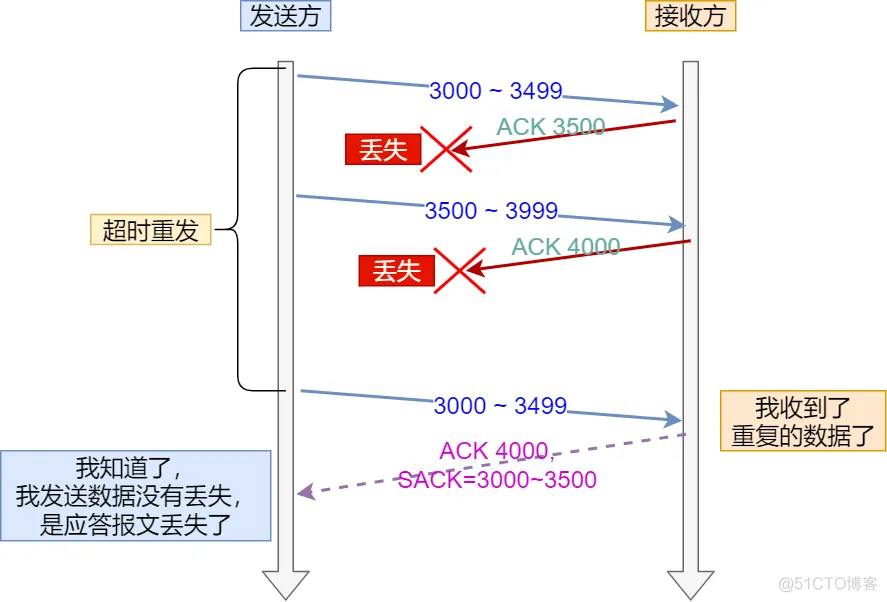
4.1. ACK丢包
- 「接收方」发给「发送方」的两个 ACK 确认应答都丢失了,所以发送方超时后,重传第一个数据包(3000 ~ 3499)
- 「接收方」发现数据是重复收到的,于是回了一个 SACK = 3000
3500,告诉「发送方」 30003500 的数据早已被接收了,因为ACK都到了 4000 了,已经意味着 4000之前的所有数据都已收到,所以这个 SACK 就代表着D-SACK。 - 这样「发送方」就知道了,数据没有丢,是「接收方」的 ACK 确认报文丢了。
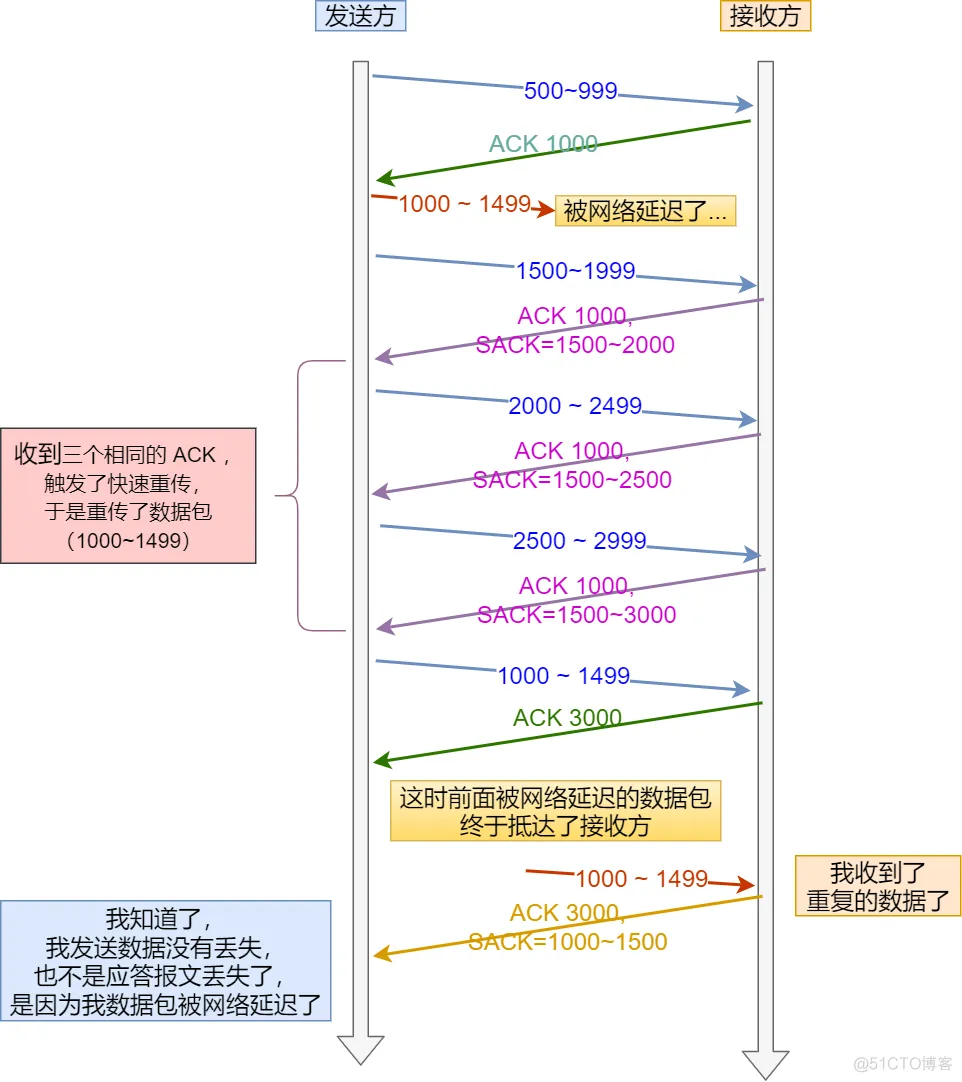
4.2. 网络时延
- 数据包(1000~1499) 被网络延迟了,导致「发送方」没有收到 Ack 1500 的确认报文。
- 而后面报文到达的三个相同的 ACK 确认报文,就触发了快速重传机制,但是在重传后,被延迟的数据包(1000~1499)又到了「接收方」;
- 所以「接收方」回了一个 SACK=1000~1500,因为 ACK 已经到了 3000,所以这个 SACK 是 D-SACK,表示收到了重复的包。
- 这样发送方就知道快速重传触发的原因不是发出去的包丢了,也不是因为回应的 ACK 包丢了,而是因为网络延迟了。
4.3. 优势
在TCP重传场景下,Duplicate SACK (D-SACK) 是TCP选择性确认 (SACK) 机制的一个扩展,具有以下重要作用:
- 检测重复数据包接收:D-SACK允许接收方通知发送方它收到了重复的数据段,无论这些重复段是否在接收方的当前接收窗口内。
- 区分网络问题类型:
- 帮助发送方区分是网络延迟导致的数据包重排,还是数据包丢失
- 区分数据包被网络复制还是发送方重传导致的重复
- 改进拥塞控制:
- 通过正确识别非拥塞丢包情况,避免不必要的拥塞窗口缩小
- 当重复包是由网络延迟而非丢包引起时,可以避免错误的重传超时调整
- 优化重传策略:
- 减少不必要的重传,提高网络带宽利用率
- 允许更精确地计算往返时间(RTT)
- 提高网络性能:
- 特别是在无线网络等高丢包环境中效果显著
- 减少由于错误解读网络状况而导致的性能下降
D-SACK是在RFC 2883中定义的,它通过允许接收方报告重复收到的数据段,使TCP协议能够更智能地应对网络中的各种异常情况,从而提高网络传输效率和可靠性。Note在 Linux 下可以通过
net.ipv4.tcp_dsack参数开启/关闭这个功能(Linux 2.4 后默认打开)
5. tcp user timeout
可以针对不同应用设置超时时间,当数据发送超过设置时间后仍然没有ack,或者迟迟读不到数据,就放弃链接。tcp user timouet可以使用setsockopt函数实现。
<span class="tag">#include</span> <sys/socket.h>
int setsockopt(int sockfd, int level, int optname, const void *optval, socklen_t optlen);
- sockfd:套接字描述符,指定要设置选项的套接字。
- level:协议级别,指定选项所在的协议层。常见值包括:
SOL_SOCKET:套接字层级选项IPPROTO_TCP:TCP协议选项IPPROTO_IP:IP协议选项IPPROTO_IPV6:IPv6协议选项
- optname:选项名称,指定要设置的特定选项。不同协议层有不同的选项,例如:
SO_REUSEADDR、SO_KEEPALIVE(套接字层)TCP_NODELAY、TCP_USER_TIMEOUT(TCP层)IP_TTL(IP层)
- optval:选项值的指针,指向包含新选项值的缓冲区。
- optlen:
optval缓冲区的大小(以字节为单位)。
5.1. 控制tcp连接超时时间
具体来说,TCP_USER_TIMEOUT定义了TCP在放弃连接之前等待未确认数据的最长时间。当一个TCP连接已经建立,并且发送方发送了数据但长时间没有收到确认(ACK)时,这个参数决定了发送方等待多久后认为连接失效。
- 不控制建立连接的超时:TCP 连接建立(三次握手)的超时通常由系统内核参数如
tcp_syn_retries控制,或者在应用程序中通过connect()调用的超时机制控制。 - 控制数据传输过程中的超时:当连接已建立,并且有未确认的数据时才生效。
int timeout = 30000;  // 30秒(毫秒为单位)
setsockopt(sockfd, IPPROTO_TCP, TCP_USER_TIMEOUT, &timeout, sizeof(timeout));
5.2. 用途
主要用于检测网络异常导致的对端无响应情况,特别是在长连接应用中,可以更早地检测到连接断开,而不是一直等待TCP的默认重传机制耗尽,在java应用中可以通过设置数据库关键配置#1. socketTimeout|socketTimeout控制。
评论